A. CertTA:鲁棒可认证的流量分析框架
- title:CertTA: Certified Robustness Made Practical for Learning-Based Traffic Analysis
- coj:USENIX Securitry 25
- Link:https://www.usenix.org/conference/usenixsecurity25/presentation/yan-jinzhu
- note:鲁棒区域和数学推导的结合不错,可供借鉴;鲁棒区域的可解释性通过结果的稳定程度来表达,这点比较有意思
背景意义
随着AI在网络流量分析中的广泛应用,基于机器学习的模型在入侵检测、应用识别等任务中表现出高准确率。然而,这些模型在面对对抗攻击时表现出严重的脆弱性,攻击者可通过数据包延迟、填充、插入等方式构造对抗流量,误导模型判断,导致AI驱动的流量分析系统在实际应用中缺乏安全性保障。因此,为AI驱动的流量分析系统提供可证明的鲁棒性保障,成为当前亟需解决的关键问题。
现有研究主要采用可认证鲁棒性方法(如随机平滑)为AI模型提供理论安全保证。在流量分析领域,现有方法主要分为两类:

- 将流量数据视为连续向量,认证其上的加性扰动;
- 将流量视为离散序列,认证数据包的插入、删除等离散扰动。
离散扰动比较好理解即增删改排,而所谓加性扰动其实就是数学游戏,对连续向量施加的改动无非就是改数值、调时隙,在数学上将这种扰动量化为加性噪声ΔL,严格来说论文中的“加性扰动”是在工程里是对离散包做的,但可以在理论里被当成连续向量上的 ℓ∞ 【ℓ∞ 范数 ‖Δx‖∞ = maxᵢ |Δxᵢ|:逐维单独算,只要最狠的那一下不超标,就认你安全**】样式扰动**来处理。然而,现实中的对抗攻击往往是多模态的,同时包含加性和离散扰动,并且且不同模型结构和输入表征差异较大,现有方法很难提供通用且有效的鲁棒性保证。(这里比较直观能想到可以结合这两种思路来进行平滑兼容)
方法结构
本文提出CertTA框架,创新性地引入多模态随机平滑方法,同时应对加性和离散对抗扰动,核心思想包括:
- 多模态随机平滑:从原始流量中随机选取部分数据包,并在其长度和时间间隔上添加指数型噪声,生成多个平滑样本;
- 鲁棒区域推导:通过理论分析,推导出分类结果在多模态扰动下保持不变的鲁棒区域,提供可认证的分类准确率下界;
- 联合防御机制:将CertTA与异常检测系统结合,构建能同时应对强攻击和隐蔽攻击的联合防御系统,提升整体防护能力。

CertTA的核心有两个,一个是多模态的随机平滑,另一个是所谓的鲁棒区域。
多模态随机平滑基本上融合了两种传统鲁棒认证思路的特点,通过离散采样和附加指数型扰动,来尽可能增大对样本随机空间覆盖程度,支撑后续鲁棒空间的推导。
对输入样本多轮平滑后得到的输出样本即可用于分类决策,论文实际的实现也是如此,后续基于基分类器进行多数投票(plurality vote):对一批加了随机扰动后的平滑样本跑模型,把得票最多的那个类别当作最终预测。
鲁棒区域如何理解?下面是原文中的数学推导,看起来很复杂,我们简单草履虫式的思考一下:一个不规则点块经过随机扩散(like水溶)后得到一个大很多的扩散区域,我们需要画圈圈出尽可能多的原本的点块。在实际操作时,我们会发现鲁棒的区域很难界定,不规则而且不同部分的扩散也各不相同,那么有什么好办法呢?愚蠢的草履虫决定反复画圈,每一圈尽可能基于当前时刻的扩散情况圈出更多,在经过很多次之后,好的,你得到了这些圈中重叠的这个部分,好了这时候你发现只要圈尽可能包含这个部分,那么你总是能够过及格线,非常之鲁棒。
回到论文,所谓的鲁棒区域即在何种程度上不影响多数投票的结果,对各种扰动构成的波函数进行采样,只要确定最终分类稳定即可,数学推导验证了这个区域存在,并且存在下界,具体鲁棒区域的大小,取决于你的“及格线”容度。

结果小结
研究还提出了一个联合防御系统,将异常检测系统与CertTA框架结合,该系统能够同时应对不同强度的对抗攻击。其中,异常检测系统首先从所有流量中过滤出异常告警流量,再将其余未告警流量(对应那些强扰动干扰的部分)输入CertTA框架进行可认证鲁棒的流量分类。

其他
论文一共跑了 6 种异构基分类器,覆盖传统机器学习、深度 CNN、RNN、Transformer 等不同结构,以及三种常见流量表征(统计特征、原始序列、原始字节)。列表如下:
- FlowLens(基于决策树的传统 ML,用手工统计特征)
- FS-Net(1-D CNN + 注意力,原始流量序列输入)
- DeepPacket(CNN,原始字节输入)
- AppScanner(堆叠 CNN + 全连接,原始字节)
- LSTM-based classifier(两层 LSTM,原始序列)
- Transformer-based classifier(自注意力序列模型,原始序列)
所有模型都在公开数据集(CICIDS2017、USTC-TFC2016 等)上重新训练,然后套进 CertTA 的随机平滑管道,用来验证“同一份证书”对不同架构、不同输入表征都能给出可证明鲁棒下界。
B. 深度学习与传统机器学习在加密恶意流量分类中的对比研究
- title:When a RF beats a CNN and GRU, together—A comparison of deep learning and classical machine learning approaches for encrypted malware traffic classification
- coj:Computers & Security, 2022
- Link:https://www.sciencedirect.com/science/article/pii/S0167404822003923
- note:回想起来,平时交流讨论中,大家总能见到各种比较脸熟的模型,诸如ML\DL\Graph-Based之类,能够感觉大部分研究中RF的效果都不错,在此之前基本是偏感性的理论认识,本篇研究相当于给了比较实际的实验结果作为支撑
背景意义
随着深度学习的大热,不论是学术界还是工业界,大家对深度学习模型的信任与期望越来越高,大家都在卷深度学习,这也致使深度学习成了加密流量分析中的默认解。本文的目的是为了探究,复杂的深度学习模型是否优于传统机器学习模型,或者说,传统的机器学习模型是否已经够用了呢。
本文实验从三个数据集、多种分类任务中,较全面的对比传统机器学习与深度学习的分类表现。实验结果表明,在某些任务中,传统机器学习可以提供更简易、高效的解决方案,但这并不代表传统机器学习可以完全取代深度学习在加密流量分析中的作用。
数据集
本文基于现有的5个公开数据集,创建了3个用于实验的数据集。其中现有数据集分别为:
- StratosphereIPS:由真实环境中的正常流量与恶意网络流量组成。
- ISCX2016:由不同应用和流量类型的正常流量样本,以及VPN流量组成。
- BOA:由不同操作系统、浏览器和应用程序产生的正常流量组成。
- MTA:由恶意流量分析网站共享出的恶意流量样本组成。
- USTC:由中科大产生的多种应用程序的正常流量和多种恶意软件的流量组成。
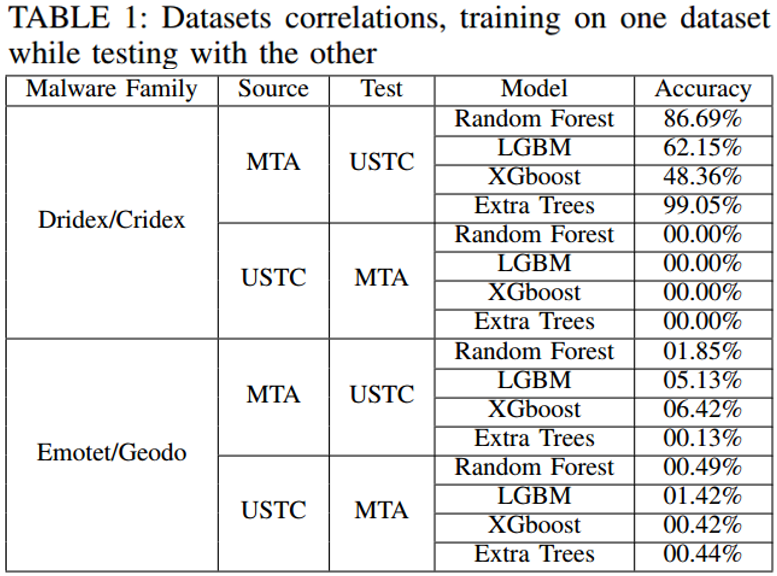
作者在合并数据集后发现,用不同数据集的相同家族恶意流量训练出来的模型并不通用,且分类准确率为0,结果如上表所示。所以,在创建数据集时,本文将不同数据集的相同家族恶意流量视为不同类别。创建的3个数据集如下:
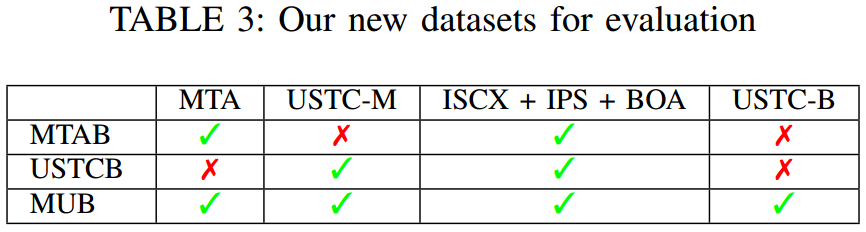
- MTAB:由MTA中的恶意流量与ISCX2016、StratoshpereIPS和BOA中的正常流量组成。
- USTCB:由USTC中的恶意流量与ISCX2016、StratoshpereIPS和BOA中的正常流量组成。
- MUB:由MTA、ISCX2016中的恶意流量与ISCX2016、StratoshpereIPS、BOA和USTC中的正常流量组成。
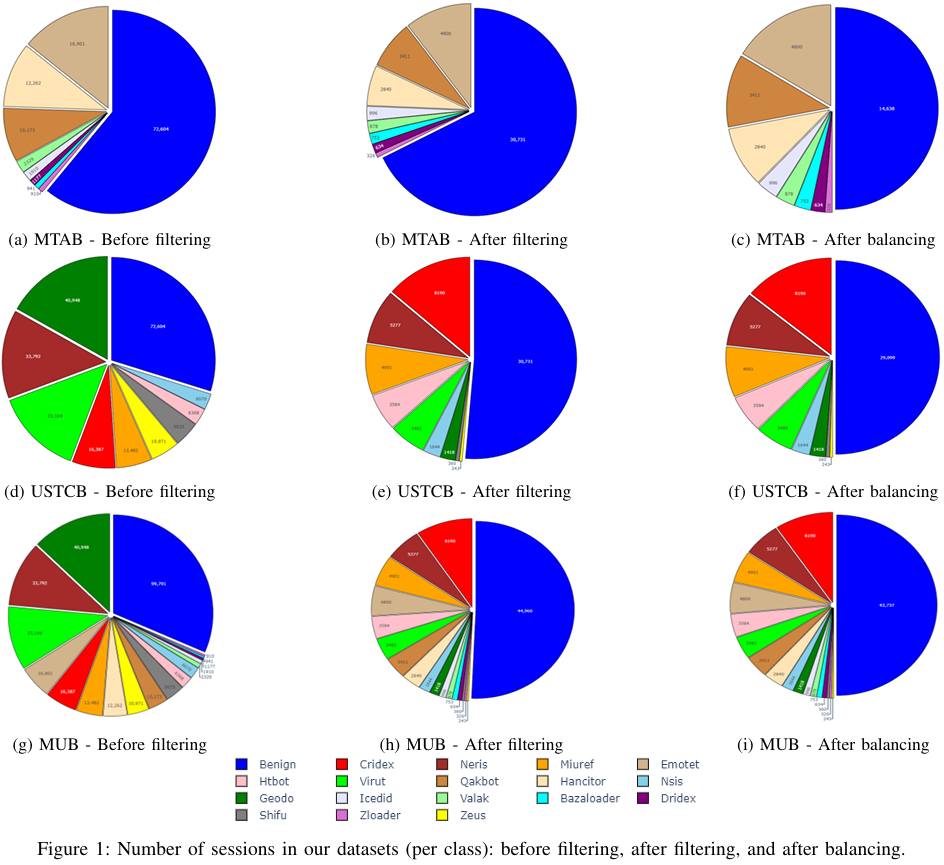
在处理数据时,作者首先过滤payload少于784字节的包,因为它们能提供的有用信息较少;其次,移除数据集中的无关协议,如SNMP、局域网广播协议等;最后,为了平衡加密恶意流量与正常流量的比例,对正常流量进行随机采样。各个数据集的数据类型占比如下图所示。
方法&结果
研究选取了二分类、多分类两种典型场景来对比众多学习模型的实际效果;得出各自最优模型(ML-RF; DL-MalDIST)后,又针对零日恶意流量和恶意软件家族递增两种特定检测情景来对比和评估模型的实际表现、鲁棒性等指标。下表是整体结果(各模块实验见后):
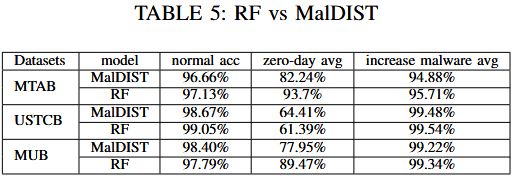
总体来说,RF的表现并不比深度学习差,
传统机器学习方面,本文选取了基于距离的KNN、基于树的DT和基于集成的RF;深度学习则选取了DeepMAL、MalDIST、M1CNN3、M2CNN和MalDIST。
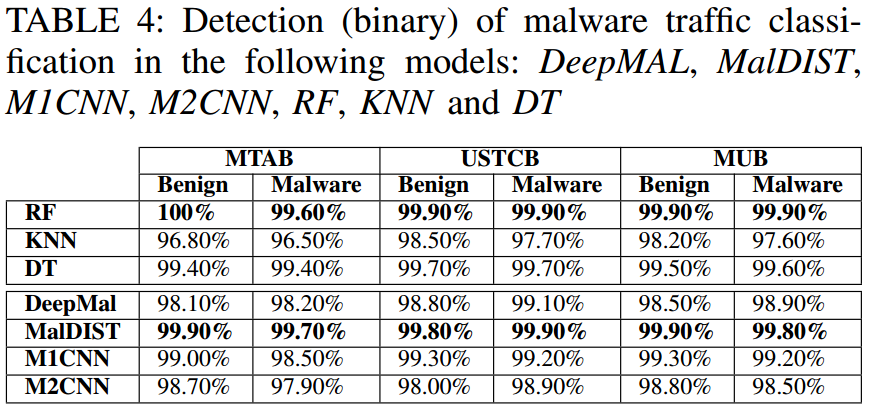
二分类场景下,以Accuracy为评估标准,其中KNN的表现最差,RF的表现最优,且优于深度学习模型中表现最好的MalDIST。
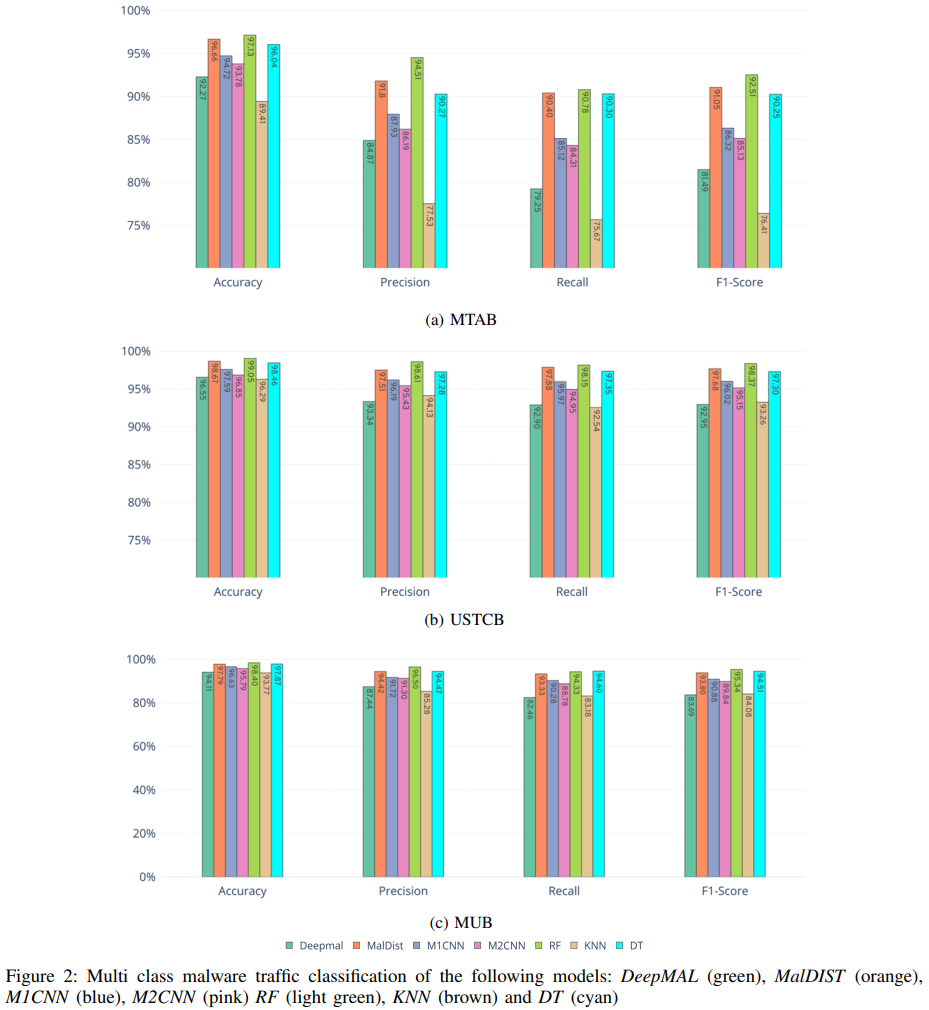
多分类场景只针对恶意流量,但由于不同类型的恶意流量数量规模并不一致,所以实验增添了额外3种评估标准,对比模型在三种定制数据集上的表现。该结果与二分类结果相似,KNN最差,RF最优且优于MalDIST。
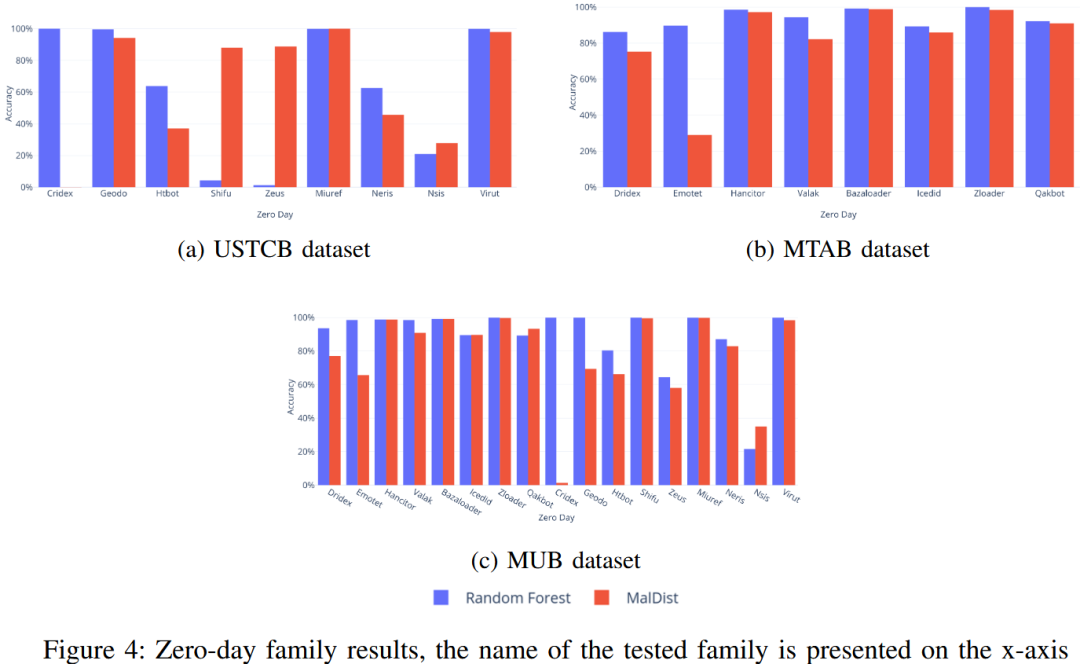
探究RF和MalDIST对零日恶意流量检测的表现时,实验每次将一个恶意家族作为测试集,其余家族和正常流量作为训练集进行二分类测试,评估指标为准确率。结果表明,在MUB数据集上,RF在所有家族检测上都优于MalDIST;但在USTCB数据集上,RF在Geodo和Htbot等家族上表现更好,而MalDIST在Nsis和Zeus等家族上表现更佳,且在极端案例中差异尤为明显,如RF对Cridex识别率为90%,而MalDIST仅为0.6%;相反,RF无法识别Shifu和Zeus,而MalDIST能有效识别;在MUB数据集中也出现类似现象。
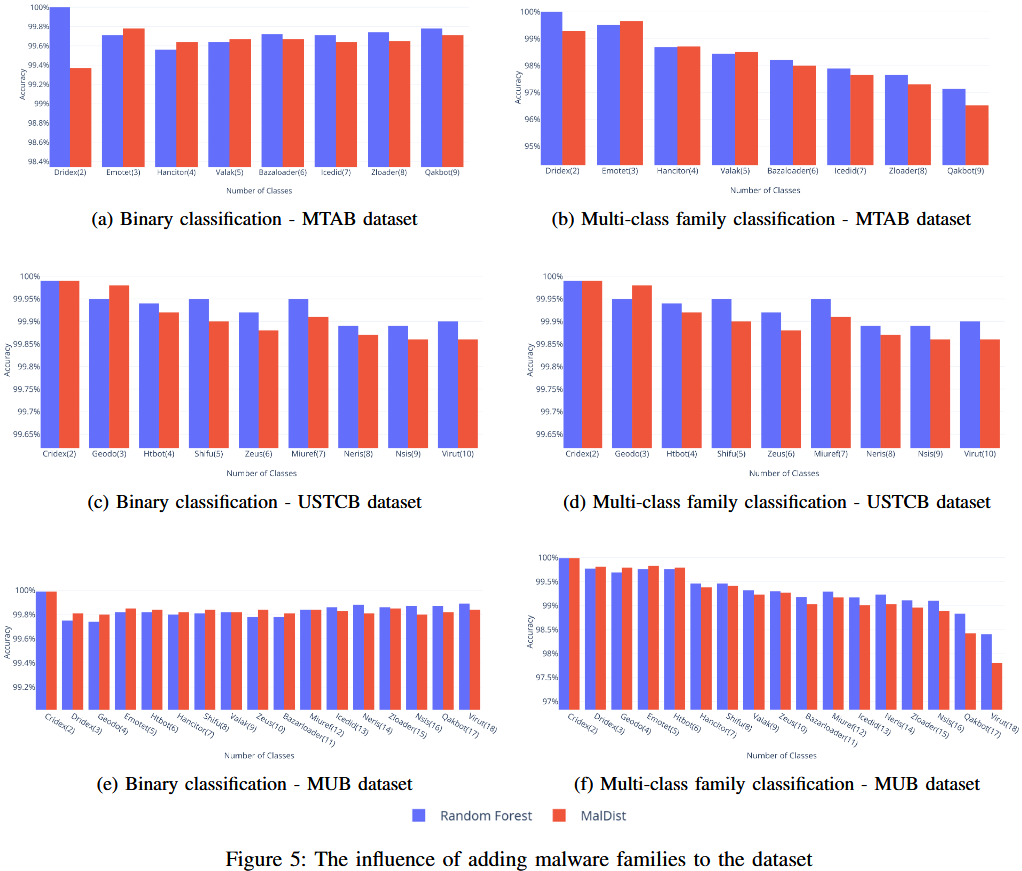
为了评估恶意软件家族数量逐步增加对模型性能的影响,本实验为每个数据集依次加入新的家族,并记录每一步的模型准确率。结果表明,随着家族数量的增加,在进行恶意和正常流量二分类时,两种模型都表现出较高的性能;在进行具体家族分类任务时,模型性能整体呈下降趋势,MTAB数据集上下降最显著。整体上,RF与MalDIST的表现大致相当,未出现明显优劣差距。
C. 加密恶意流量特征挖掘研究
- title:Feature Mining for Encrypted Malicious Traffic Detection with Deep Learning and Other Machine Learning Algorithms
- coj:Computers & Security, 2023
- Link:https://www.sciencedirect.com/science/article/pii/S0167404823000536
- note:这篇研究比较可取的是对加密流量特征的划分方法,有类似需要可以借鉴
背景意义
特征工程是流量检测和分类工作中一个极为重要的部分,早期的的分析基本都是依赖强规则,解释性较强,随着防护技术和对抗手段的进步,能够获取到的有信息量和代表性的流量特征越来越少,一些机器学习的办法被运用到流量的特征学习中,但效果提升并不显著,并且训练成本、数据支撑、可解释性等都有不少限制,基于优势特征(具备强判别性)的分类仍然是主流。该条路线对应的问题主要是来个,一来特定协议的特征越来越难以获取,优势特征愈发稀疏(加密、混淆等干扰),二来协议无关特征无法充分表征特定对象。
针对上述问题,本篇研究提出了一种面向加密恶意流量分析的新型特征设计思路;另外提出了一个融合ML和DL的两层检测框架。除此之外,构建了一个整合数据集,其结果评估要优于ResNet、RF等经典方法。
方法结构
研究将传统加密流量特征划为协议相关特征和协议无关数值特征两大类,并基于两类特征的特点提出了一种新型的加密流量特征创建方法——特定加密流量特征(Enc Feature),该方法主要在加密流量的会话层、数据层两个粒度上进行特征提取。
-
协议相关特征(Protocol-specific Features):针对特定加密协议提取的特征,依赖于协议本身的结构新型,如版本类型、证书有效期等。——此类特征粒度较细,提取过程耗时;对特定协议的分辨力较强,但扩展性较差。
-
协议无关特征(Protocol-agnostic Numerical Features):不依赖具体加密协议的通用特征,如负载大小、生存时间、流持续时间等。进一步可细分为基于数据包的特征和基于会话的特征两种。前者针对单包提取,包括包载荷长度、到达间隔等;后者针对会话提取,代表特征如会话持续时间、总字节数等。——此类特征相对普及,但分辨力不高。
此前的研究往往不区分加密与非加密流量,使用相同的特征集进行分析,导致特征判别力下降。Enc Feature不仅具有协议无关性,同时兼顾会话层和数据包层信息,是目前唯一在这两个维度上同时针对加密流量设计的特征体系。下表为Enc Feature的概览:
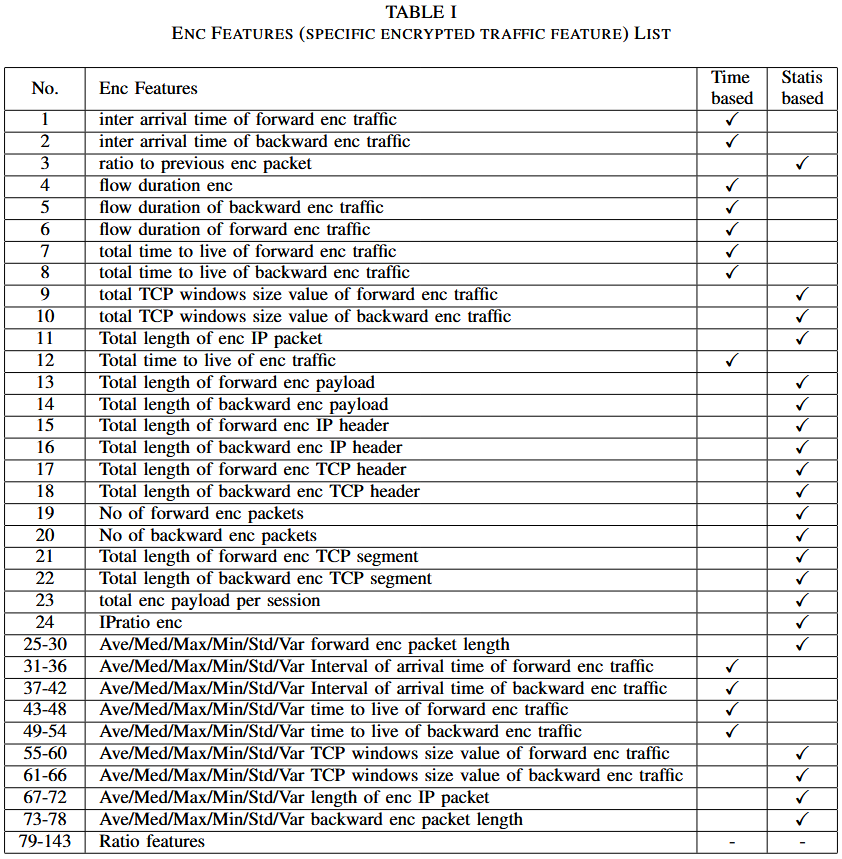
Enc Feature的核心在于仅从加密会话的加密数据包中提取特征,完全排除非加密数据包(如TLS中握手包),从而提取纯粹反映加密流量行为的特征。流程分两步:
- 过滤混合数据集中所有非加密会话
- 从加密会话中剔除所有非加密数据包
最终提取78个Enc特征,包括会话级(4-23)、包级(1-3,24),以及通过统计运算生成的特征(25-78)。除此之外,研究还将Enc Feature与传统协议无关特征结合,例如,传统流持续时间与仅基于加密包的流持续时间比值,IP总包长与加密IP包长度比值,从而拓展了加密流量的特征维度(No.79–143)。具体特征如表I所示,与现有方法区别如表II和III所示。
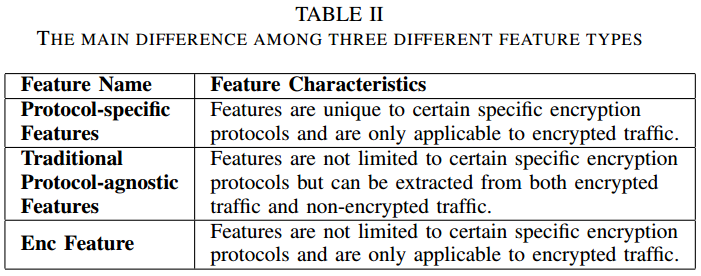
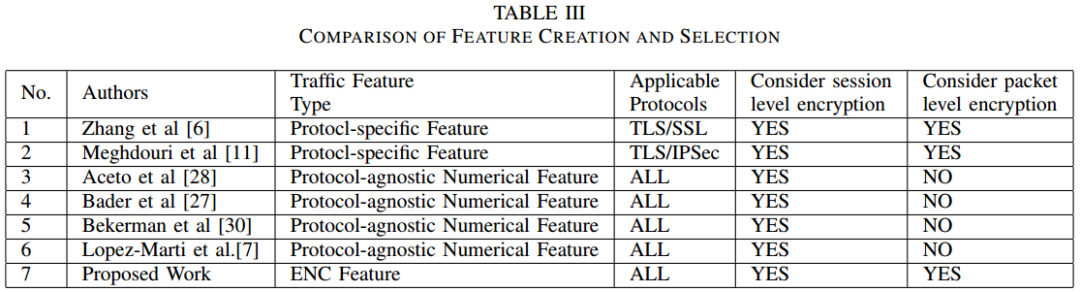
研究提出了一个两层加密恶意流量检测框架,如下图示:
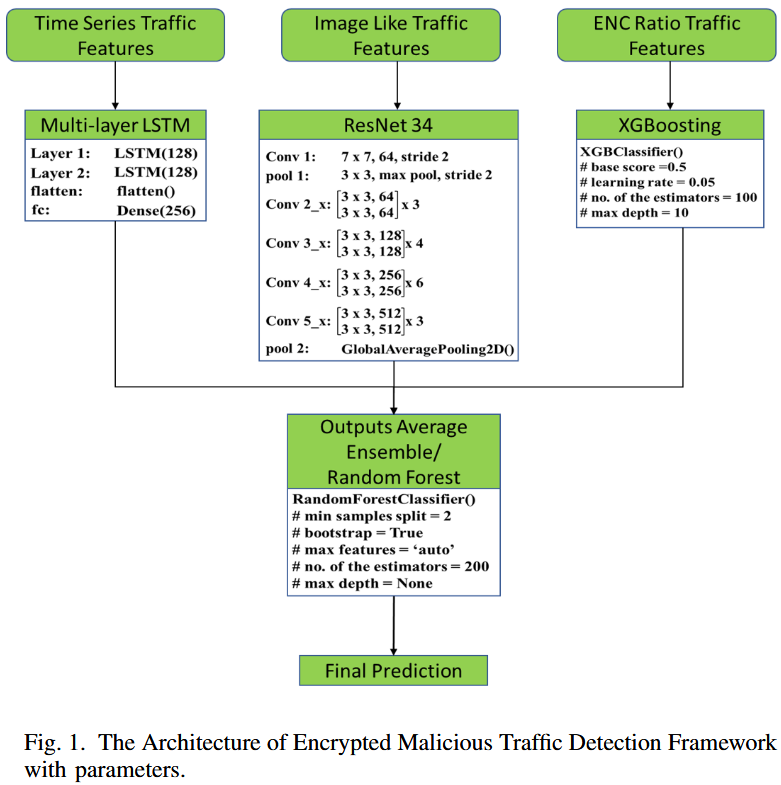
框架中根据特征类型将其分别输入不同模型:
- 时间相关特征输入RNN模型(如GRU、LSTM)
- 基于负载的侧信道特征被编码为二维图像输入CNN模型(如ResNet)
- 传统协议无关特征与Enc特征之间的比值型特征输入传统机器学习模型(如Random Forest、XGBoost)。
第一层由上述各模型中性能最优者构成,其输出的概率结果作为输入传递给第二层检测器。第二层检测器由Random Forest或平均集成方法构建,依据不同评估指标的重要性决定最终选择。
检测框架的工作流程:首先,通过Wireshark过滤非加密流量,再从PCAP中提取300余种特征,包括时间相关特征、payload侧信道特征、自定义加密特征与比例特征。随后,针对不同特征类型选择最合适的模型进行训练:时间相关特征以15×85的格式输入LSTM模型,多层LSTM表现最佳;payload侧信道特征以15×38的二维数组形式输入ResNet模型,ResNet34表现最佳;加密与传统协议无关特征的比值特征输入传统模型训练,XGBoost略优于Random Forest。这三种模型的预测结果将输入第二层检测器,通过Random Forest或平均集成法实现最终判别。
数据集
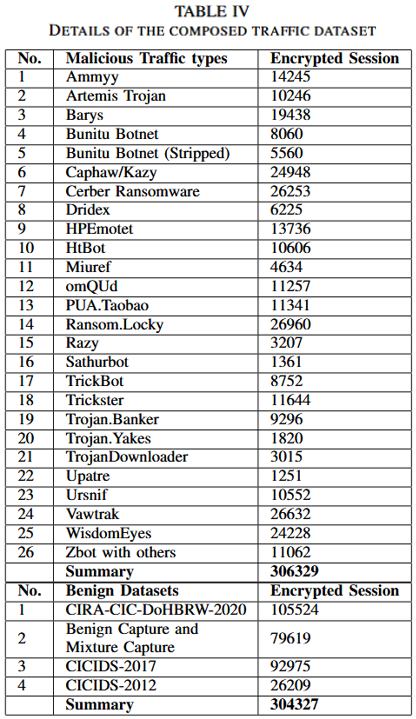
为提升流量数据的多样性,本文从6个公共数据集中整合构建了新的加密流量数据集。该数据集包括Stratosphere Lab发布的CTU-Malware-Capture、Benign-Capture与Mixture-Capture,以及加拿大网络安全研究所(CIC)发布的CICIDS2017、CICIDS2012和CIRA-CIC-DoHBRW-2020。其中,CTU数据集提供26类恶意流量,其他五个数据集则提供正常流量,以实现数据类别平衡和流量多样性最大化。
结果小结
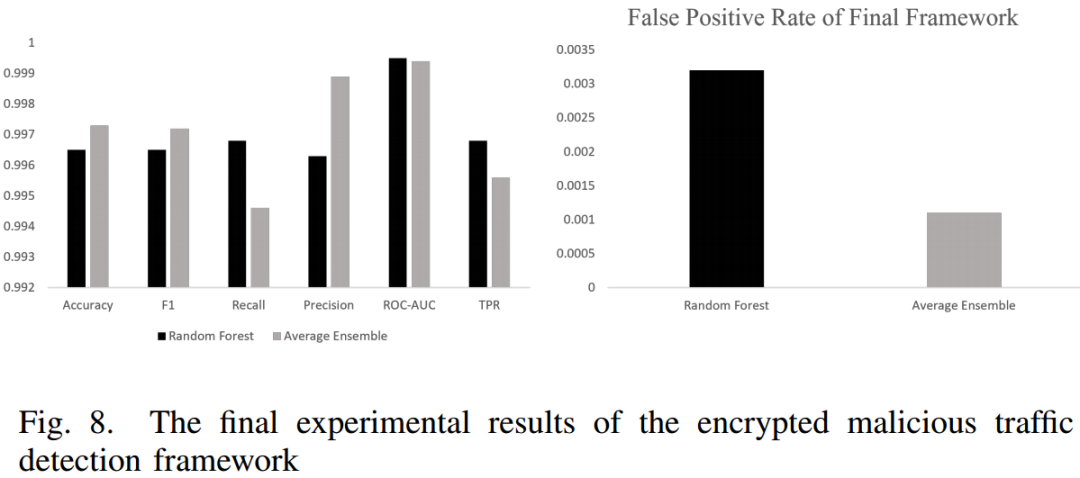
实验结果表明,若第二层采用Random Forest,TPR可达99.68%;若采用平均集成方法,则在准确率(99.73%)、F1值(99.72%)、精确率(99.89%)与最低误报率(0.11%)方面表现略优。
简言之,本文提出了一种加密恶意流量检测框架,涵盖特征提取、模型训练及多层检测机制。但这类基于数据集的研究,一个比较常见的问题就是实际网络的表现如何?面对复杂流量的鲁棒性怎样?受数据集质量的影响大小等。这篇研究比较可取的是对加密流量特征的划分方法,有类似需要可以借鉴,至于所提的Enc Feature,尽管经过各种增强,但实际起核心作用的应该还是1-24号特征,研究也并未进行消融评估。
Refer
- 安全内参:CertTA:流量分析的可证明安全
- 安全内参:深度学习与传统机器学习在加密恶意流量分类中的对比研究
- 安全内参:加密恶意流量特征挖掘研究